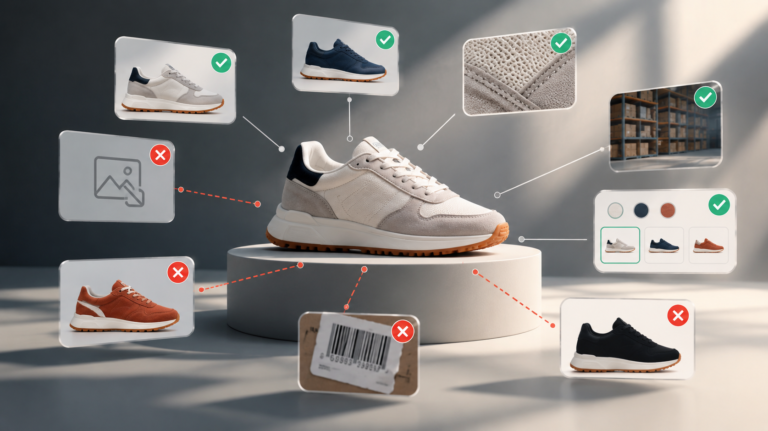
Ένα e-shop μπορεί να διαθέτει χιλιάδες προϊόντα και παρ’ όλα αυτά να έχει πολύ λιγότερα «κατανοητά» προϊόντα από όσα νομίζει.
Το πρόβλημα δεν βρίσκεται απαραίτητα στο inventory. Βρίσκεται στα product data που περιγράφουν αυτό το inventory: τίτλοι, brands, GTINs, variants, χρώματα, μεγέθη, υλικά, εικόνες, availability και η σχέση ανάμεσα σε όλα αυτά.
Όσο το discovery γίνεται περισσότερο visual και multimodal, αυτή η λεπτομέρεια αποκτά μεγαλύτερη επιχειρηματική σημασία. Ένα προϊόν μπορεί να υπάρχει στο warehouse και στο e-shop, αλλά αν τα δεδομένα του είναι ελλιπή, ασυνεπή ή λανθασμένα, μπορεί να γίνει δυσκολότερο για search engines και shopping systems να το καταλάβουν και να το εμφανίσουν σωστά.
Για το Market Insiders, αυτό είναι το Product Data Gap: η απόσταση ανάμεσα στο προϊόν που η επιχείρηση πραγματικά διαθέτει και στο προϊόν που τα συστήματά της μπορούν να περιγράψουν με ακρίβεια.
Ένας μεγάλος κατάλογος δεν είναι απαραίτητα καλός κατάλογος
Η ανάπτυξη ενός e-commerce catalog συχνά μετριέται σε αριθμό SKUs: 10.000, 50.000 ή ακόμη και 200.000 προϊόντα. Ο αριθμός αυτός όμως λέει πολύ λίγα για την πραγματική ποιότητα των δεδομένων που συνοδεύουν το inventory.
Ένας κατάλογος μπορεί να είναι τεράστιος και ταυτόχρονα γεμάτος διαφορετικές ονομασίες για το ίδιο attribute, ελλιπή identifiers, παλιά availability data, duplicate products ή εικόνες που δεν αντιστοιχούν σωστά στα variants. Σε αυτή την περίπτωση, η κλίμακα γίνεται παραπλανητική: η επιχείρηση διαθέτει μεγάλο inventory, αλλά όχι απαραίτητα ένα καθαρό και συνεπές product information layer.
Όσο περισσότερα channels προσπαθούν να αξιοποιήσουν αυτά τα δεδομένα, τόσο πιο ορατό γίνεται το πρόβλημα. Ένα catalog που λειτουργεί οριακά μέσα στο ίδιο το e-shop μπορεί να αρχίσει να παρουσιάζει σοβαρές αδυναμίες όταν πρέπει να τροφοδοτήσει search engines, marketplaces, Merchant Center και νέα discovery environments.
Το product data έχει γίνει μέρος της discoverability
Στο παλιότερο ecommerce model, τα product data μπορούσαν εύκολα να αντιμετωπιστούν ως back-office θέμα. Το marketing έφερνε traffic, το site παρουσίαζε το προϊόν και το ERP ή το PIM κρατούσε τις πληροφορίες του catalog.
Σήμερα αυτά τα επίπεδα είναι πολύ περισσότερο συνδεδεμένα. Η Google χρησιμοποιεί product data για να αντιστοιχεί προϊόντα με queries και να τα εμφανίζει σε ads και free listings, ενώ ελλιπή ή λανθασμένα attributes μπορούν να οδηγήσουν σε περιορισμένη eligibility, λανθασμένη εμφάνιση ή ακόμη και product disapprovals.
Με άλλα λόγια, ένα catalog error δεν παραμένει απαραίτητα «πίσω από το site». Μπορεί να μετατραπεί άμεσα σε visibility problem και να επηρεάσει το αν ένα προϊόν θα ανακαλυφθεί εξαρχής.
Η εικόνα χωρίς metadata δεν αρκεί
Το visual discovery μπορεί εύκολα να δημιουργήσει την εντύπωση ότι το βασικό ζητούμενο είναι οι καλές φωτογραφίες. Στην πράξη, η εικόνα είναι μόνο ένα μέρος του συστήματος.
Χρειάζεται να συνδέεται με σαφή πληροφορία για το προϊόν που απεικονίζει. Το Google Merchant Center, για παράδειγμα, αντιμετωπίζει το image_link ως βασικό product attribute και συνδέει την εικόνα με πληροφορίες όπως brand, GTIN, MPN, price και availability.
Μια εντυπωσιακή product image επομένως δεν διορθώνει από μόνη της ένα discovery problem. Αν το ίδιο προϊόν εμφανίζεται με διαφορετικό brand name σε διαφορετικά systems, αν λείπει το color attribute ή αν το GTIN είναι λανθασμένο, το underlying data παραμένει προβληματικό.
Η visual layer είναι τελικά τόσο αξιόπιστη όσο και η πληροφορία που βρίσκεται πίσω από αυτή.
Το visual discovery αποκαλύπτει catalog inconsistency
Το πρόβλημα γίνεται πιο εμφανές όταν ο πελάτης ψάχνει με βάση οπτικές λεπτομέρειες όπως χρώμα, pattern, material, shape ή ένα συγκεκριμένο variant.
Αν, για παράδειγμα, ένα fashion retailer διαθέτει το ίδιο sneaker σε πέντε χρώματα αλλά όλα τα variants χρησιμοποιούν την ίδια γενική εικόνα ή δεν έχουν σωστά color attributes, το catalog δεν περιγράφει με ακρίβεια αυτό που πραγματικά πουλά. Το ίδιο μπορεί να συμβεί σε furniture, consumer electronics, luggage ή accessories.
Η Google υποστηρίζει ProductGroup structured data ακριβώς για να μπορεί να συνδέει variants του ίδιου προϊόντος και να διακρίνει χαρακτηριστικά όπως size, color, material και pattern. Αυτό δείχνει πόσο σημαντικό έχει γίνει το variant-level accuracy.
Το product data δεν μπορεί πλέον να λειτουργεί μόνο στο επίπεδο του «γενικού προϊόντος». Πρέπει να αποτυπώνει και τις διαφορές που ο πελάτης πραγματικά βλέπει.
Τα variants είναι από τα πιο δύσκολα σημεία ενός catalog
Από την πλευρά του χρήστη, τα variants φαίνονται απλά: μαύρο ή μπλε, leather ή fabric, μικρό ή μεγάλο μέγεθος. Στο backend όμως μπορούν να δημιουργήσουν σημαντική πολυπλοκότητα.
Η επιχείρηση πρέπει να γνωρίζει ποιο variant έχει δικό του SKU, ποιο χρειάζεται ξεχωριστή εικόνα, ποιο έχει διαφορετικό GTIN, ποια availability ισχύει και ποια attributes ανήκουν στο parent product ή στο individual variant.
Η Google χρησιμοποιεί properties όπως variesBy, hasVariant και productGroupID για να καταλάβει ότι διαφορετικές εκδόσεις ανήκουν στην ίδια product family. Αν αυτά τα relationships δεν είναι καθαρά, ο κατάλογος μπορεί να φαίνεται απλός στον άνθρωπο αλλά εξαιρετικά ασυνεπής για τα systems που πρέπει να τον διαβάσουν.
Η μεγαλύτερη κλίμακα αυξάνει το Product Data Gap
Ένα catalog 100 προϊόντων μπορεί να διορθωθεί σχετικά εύκολα με manual work. Σε ένα catalog 100.000 προϊόντων, όμως, η ίδια προσέγγιση παύει να είναι βιώσιμη.
Όσο μεγαλώνει το inventory, αυξάνεται και η πιθανότητα να εμφανιστούν duplicate records, παλιά attributes, ασυνεπή naming conventions, missing identifiers, λάθος εικόνες, outdated availability ή διαφορετικές τιμές μεταξύ systems.
Σε αυτό το σημείο, το πρόβλημα δεν είναι μόνο data quality. Είναι και data governance.
Ποιος έχει τελικά την ευθύνη για το product record; Το ecommerce team, το procurement, ο supplier, το ERP, το PIM ή το marketing; Αν η απάντηση είναι «όλοι λίγο», το Product Data Gap μπορεί να μεγαλώνει για χρόνια χωρίς να έχει πραγματικό owner.
Το catalog γίνεται coordination problem
Αυτό συνδέεται με μια ευρύτερη επιχειρηματική αρχή που έχουμε ήδη εξετάσει στο Market Insiders μέσα από το “The Cost of Complexity”. Όσο αυξάνονται τα προϊόντα, τα systems, τα channels και τα data sources, τόσο αυξάνεται και το coordination cost που απαιτείται για να παραμείνουν όλα συγχρονισμένα.
Ένα attribute που αλλάζει σε ένα system μπορεί να πρέπει να ενημερωθεί σε τρία ακόμη. Μια νέα product category μπορεί να χρειάζεται mapping, ένας supplier μπορεί να χρησιμοποιεί διαφορετική terminology και το ecommerce platform να έχει διαφορετική structure από το Merchant Center.
Κάθε integration προσθέτει δυνατότητες, αλλά ταυτόχρονα δημιουργεί ένα ακόμη σημείο στο οποίο τα δεδομένα μπορούν να αποκλίνουν. Σε αυτή την έννοια, το Product Data Gap δεν είναι απλώς data issue. Είναι και operational complexity issue.
Το GTIN δεν είναι μικρή λεπτομέρεια
Product identifiers όπως το GTIN λειτουργούν ως βασικοί μηχανισμοί ταυτοποίησης. Για νέα προϊόντα που διαθέτουν manufacturer-assigned GTIN, η Google αναμένει να χρησιμοποιείται ο πραγματικός identifier, ενώ το brand αποτελεί επίσης βασικό attribute στις περισσότερες product categories.
Αυτό έχει άμεση πρακτική σημασία. Αν ένα retailer χρησιμοποιεί λάθος GTIN, δημιουργεί δικούς του identifiers ή αφήνει κρίσιμα fields κενά, γίνεται δυσκολότερο για τα systems να καταλάβουν αν δύο listings αναφέρονται στο ίδιο προϊόν.
Για την επιχείρηση, ένας identifier μπορεί να φαίνεται σαν τεχνική λεπτομέρεια. Για το discovery layer, όμως, αποτελεί μέρος της identity του προϊόντος.
Τα product titles χρειάζονται συνέπεια
Η ίδια λογική ισχύει και για τους τίτλους. Ένα προϊόν μπορεί να έχει διαφορετικό title στο ERP, διαφορετικό στο e-shop και διαφορετικό feed title στο Merchant Center.
Μικρές αποκλίσεις μπορεί να είναι απόλυτα λογικές, όμως οι μεγάλες διαφορές δημιουργούν ambiguity. Ένα laptop μπορεί σε ένα system να εμφανίζεται μόνο με brand και model, σε άλλο με processor, RAM και storage και σε τρίτο με καθαρά marketing περιγραφή.
Όσο περισσότερες εκδοχές υπάρχουν, τόσο δυσκολότερο γίνεται να διατηρηθεί ένα κοινό source of truth. Το catalog χρειάζεται επομένως σαφείς κανόνες για το ποια στοιχεία είναι canonical, ποια descriptive και ποια μπορούν να προσαρμόζονται ανά channel χωρίς να αλλοιώνουν την ταυτότητα του προϊόντος.
Η availability πρέπει να είναι πραγματική
Το discovery έχει περιορισμένη αξία αν οδηγεί τον πελάτη σε προϊόν που τελικά δεν είναι διαθέσιμο. Product data όπως price και availability χρησιμοποιούνται μέσα στις merchant listing experiences, ενώ structured data μπορούν να βοηθήσουν και στην ενημέρωση αυτών των στοιχείων.
Ένα mismatch ανάμεσα στο website και το feed δεν είναι επομένως απλώς αισθητικό πρόβλημα. Μπορεί να δημιουργήσει poor customer experience, incorrect displays ή eligibility issues.
Από επιχειρηματική σκοπιά, το inventory data πρέπει πλέον να αντιμετωπίζεται ως μέρος του customer-facing system. Το stock level μπορεί να ζει στο ERP, αλλά η επίδρασή του φτάνει μέχρι το search result.
Οι εικόνες χρειάζονται governance, όχι μόνο production
Το image library δεν μπορεί πλέον να αντιμετωπίζεται απλώς σαν ένας creative φάκελος. Η κύρια εικόνα πρέπει να απεικονίζει σωστά το προϊόν, να είναι crawlable και να πληροί τις τεχνικές απαιτήσεις των platforms όπου θα χρησιμοποιηθεί.
Η επιχείρηση πρέπει επομένως να γνωρίζει ποια εικόνα ανήκει σε ποιο SKU, ποια είναι η main image, ποια είναι additional image, αν απεικονίζει πραγματικά το σωστό variant και αν το asset εξακολουθεί να βρίσκεται στο σωστό URL.
Η φωτογραφία μετατρέπεται έτσι από απλό creative asset σε data asset. Η παραγωγή της εικόνας παραμένει σημαντική, αλλά εξίσου σημαντική είναι και η σωστή σύνδεσή της με το product record.
Το Product Data Gap δημιουργεί invisible lost demand
Ένα από τα δυσκολότερα προβλήματα είναι ότι η επιχείρηση μπορεί να μην αντιλαμβάνεται καν τι χάνει.
Αν ένα προϊόν δεν εμφανίζεται σωστά σε discovery environments, δεν υπάρχει απαραίτητα εμφανές error μέσα στο ecommerce dashboard. Το SKU εξακολουθεί να υπάρχει, η product page λειτουργεί και το inventory είναι διαθέσιμο. Ο πελάτης όμως απλώς δεν το βρίσκει.
Αυτό δημιουργεί invisible lost demand. Δεν υπάρχει abandoned checkout, επειδή ο χρήστης δεν έφτασε ποτέ στο checkout. Δεν υπάρχει failed conversion, επειδή το discovery δεν έγινε εξαρχής.
Η ποιότητα του product data επηρεάζει επομένως ένα στάδιο ακόμη πιο πριν από το conversion: το αν το προϊόν θα αποκτήσει ποτέ την ευκαιρία να αξιολογηθεί.
Το Visual Search κάνει την ποιότητα του catalog πιο ορατή
Το πρόσφατο άρθρο του Targeted.gr, “Visual Search Marketing: Τι αλλάζει όταν ο πελάτης ψάχνει με φωτογραφία αντί για λέξεις;”, εξετάζει την customer-facing πλευρά αυτής της αλλαγής.
Όταν ο χρήστης μπορεί να ψάξει με εικόνα, screenshot ή camera, το product discovery γίνεται λιγότερο εξαρτημένο από το keyword. Για την επιχείρηση, όμως, αυτό σημαίνει ότι το underlying catalog πρέπει να περιγράφει σωστά αυτό που φαίνεται στην εικόνα.
Το marketing μπορεί να δημιουργήσει ζήτηση και το visual search να δημιουργήσει discovery. Το product data, όμως, πρέπει να συνδέσει σωστά το visual signal με το πραγματικό SKU, διαφορετικά το journey μπορεί να σπάσει ακριβώς στο σημείο όπου θα έπρεπε να αρχίσει.
Το PIM γίνεται στρατηγικότερο
Σε μεγάλα catalogs, τα Product Information Management systems αποκτούν μεγαλύτερη στρατηγική σημασία. Ο ρόλος τους δεν περιορίζεται στην αποθήκευση descriptions και attributes, αλλά μπορεί να λειτουργήσει ως central layer ανάμεσα σε suppliers, ERP, ecommerce platform, marketplaces και marketing channels.
Η πραγματική αξία ενός PIM δεν βρίσκεται μόνο στο centralisation. Βρίσκεται στη δυνατότητα να υπάρχει ένα συνεπές product record που μπορεί να διανέμεται παντού.
Αυτό μειώνει το duplication και επιτρέπει στην επιχείρηση να διορθώνει data problems στη ρίζα τους, αντί να εφαρμόζει ξεχωριστά fixes σε κάθε channel.
Ένα feed δεν διορθώνει ένα κακό source system
Υπάρχει όμως ένας σημαντικός περιορισμός: ένα καλό Merchant Center feed ή ένα ισχυρό integration δεν μπορεί να διορθώσει μόνιμα ένα προβληματικό underlying catalog.
Αν τα source data είναι λανθασμένα, το feed team μπορεί να καταλήξει να δημιουργεί rules, overrides και manual fixes ώστε να «καθαρίζει» τις πληροφορίες πριν διανεμηθούν. Αυτό μπορεί να λειτουργήσει προσωρινά, μακροπρόθεσμα όμως δημιουργεί ένα δεύτερο layer complexity.
Το source system λέει ένα πράγμα, το feed ένα άλλο και το site ίσως κάτι τρίτο. Σταδιακά, η επιχείρηση χάνει το πραγματικό source of truth.
Η σωστή data architecture πρέπει επομένως να διορθώνει τα προβλήματα όσο πιο κοντά γίνεται στην αρχική τους πηγή.
Τα channel-specific requirements δεν πρέπει να καταστρέφουν το core data model
Διαφορετικά channels έχουν διαφορετικές απαιτήσεις. Ένα marketplace μπορεί να ζητά συγκεκριμένο attribute, ένα δεύτερο διαφορετικό format, το Google Merchant Center έχει τις δικές του προδιαγραφές και το ecommerce site μπορεί να χρειάζεται richer descriptions.
Η προσαρμογή είναι αναπόφευκτη. Το πρόβλημα αρχίζει όταν κάθε channel αποκτά το δικό του ανεξάρτητο catalog.
Τότε η επιχείρηση δεν έχει πλέον ένα product model, αλλά πολλά σχεδόν ίδια models που σταδιακά αποκλίνουν μεταξύ τους. Η πιο βιώσιμη προσέγγιση είναι ένα strong canonical data layer πάνω στο οποίο εφαρμόζονται channel-specific transformations.
Η προσαρμογή είναι αναγκαία. Η fragmentation όχι.
Το Product Data Gap δεν είναι μόνο τεχνικό πρόβλημα
Είναι εύκολο να θεωρηθεί ζήτημα του IT, όμως η ποιότητα του catalog εξαρτάται από πολλές διαφορετικές λειτουργίες της επιχείρησης.
Το procurement γνωρίζει το προϊόν, οι suppliers παρέχουν identifiers και specifications, το marketing γράφει descriptions, το ecommerce οργανώνει categories, τα operations γνωρίζουν availability, το finance επηρεάζει pricing και το IT συνδέει τα systems.
Αυτό σημαίνει ότι το product-data quality χρειάζεται business ownership, όχι μόνο technical ownership. Χωρίς κοινά standards και ξεκάθαρες αρμοδιότητες, κάθε ομάδα μπορεί να βελτιστοποιεί το δικό της μικρό κομμάτι ενώ το συνολικό catalog παραμένει ασυνεπές.
Το catalog χρειάζεται data quality metrics
Οι επιχειρήσεις με μεγάλα product catalogs χρειάζονται έναν τρόπο να μετρούν την πραγματική ποιότητα και όχι μόνο το μέγεθός τους.
Δεν αρκεί να γνωρίζουν πόσα SKUs υπάρχουν. Χρειάζεται να γνωρίζουν πόσα διαθέτουν σωστό GTIN, πλήρες brand, main image, additional images, correct variant relationship, availability, price, consistent attributes και valid structured data.
Αυτά τα στοιχεία μπορούν να οδηγήσουν σε ένα πραγματικό catalog health score, το οποίο μετατρέπει την ποιότητα δεδομένων από αφηρημένη έννοια σε μετρήσιμο operational issue.
Αν μια επιχείρηση δεν μετρά completeness και accuracy, το Product Data Gap παραμένει αόρατο. Με metrics, μετατρέπεται σε operational backlog που μπορεί να διορθωθεί συστηματικά.
Η AI εποχή κάνει τα καθαρά product data ακόμη πιο σημαντικά
Καθώς περισσότερα systems προσπαθούν να «καταλάβουν» ένα προϊόν, τα καθαρά machine-readable δεδομένα αποκτούν ακόμη μεγαλύτερη αξία. Product information δεν χρησιμοποιούνται πλέον μόνο για κλασικό query matching, αλλά μπορούν να τροφοδοτούν shopping, advertising, recommendations, marketplaces και AI-powered interfaces.
Το visual discovery είναι επομένως μόνο μία έκφανση ενός ευρύτερου προβλήματος. Το ίδιο product layer μπορεί να επαναχρησιμοποιείται σε ολοένα περισσότερα environments.
Ένα καλό catalog δεν αποτελεί πλέον απλώς ecommerce infrastructure. Μετατρέπεται σε distribution infrastructure, πάνω στην οποία μπορεί να στηριχθεί η παρουσία του προϊόντος σε διαφορετικά digital channels.
Το mobile visual search δείχνει τι συμβαίνει στην πράξη
Το επόμενο άρθρο του Techrow.gr, “Visual Search στο κινητό: Google Lens, Circle to Search και αναζήτηση με εικόνα στην πράξη”, θα δείξει πώς ο χρήστης βιώνει αυτή την αλλαγή από την άλλη πλευρά της οθόνης, φωτογραφίζοντας ένα αντικείμενο, κάνοντας circle σε κάτι που βλέπει ή χρησιμοποιώντας screenshot ως search input.
Για την επιχείρηση, όμως, το κρίσιμο σημείο βρίσκεται νωρίτερα. Το σύστημα μπορεί να αναγνωρίσει ένα αντικείμενο οπτικά, αλλά χρειάζεται ένα σωστό product record για να το συνδέσει με price, availability, brand και συγκεκριμένο variant.
Η εμπειρία του χρήστη είναι επομένως τόσο αξιόπιστη όσο και τα δεδομένα που τροφοδοτούν το discovery layer.
Το πρόβλημα δεν διορθώνεται με περισσότερα attributes
Υπάρχει και ο κίνδυνος της υπερδιόρθωσης. Μια επιχείρηση αναγνωρίζει ότι τα product data είναι σημαντικά και αρχίζει να δημιουργεί δεκάδες νέα attributes θεωρώντας ότι περισσότερο data σημαίνει αυτόματα καλύτερο catalog.
Στην πράξη, περισσότερα fields μπορούν να δημιουργήσουν περισσότερα missing values, inconsistent values και manual work. Η λύση δεν είναι maximum data, αλλά relevant, standardised και maintainable data.
Κάθε attribute πρέπει να έχει σαφή χρήση, controlled vocabulary όπου χρειάζεται και ξεκάθαρο ownership. Διαφορετικά, η επιχείρηση απλώς μετατρέπει το data quality problem σε data quantity problem.
Το Product Data Gap μπορεί να περιορίσει την ανάπτυξη
Σε μικρή κλίμακα, τα data problems συχνά διορθώνονται manual. Όσο όμως η επιχείρηση μεγαλώνει, μπορούν να εξελιχθούν σε πραγματικό bottleneck.
Μια νέα marketplace integration μπορεί να απαιτεί μεγάλο data cleanup. Η είσοδος σε νέα χώρα μπορεί να χρειάζεται mapping και νέα standards. Το visual discovery μπορεί να αποκαλύπτει ελλιπείς εικόνες και variants, ενώ ένα νέο advertising format μπορεί να απαιτεί identifiers που δεν υπάρχουν.
Σε αυτό το σημείο, η επιχείρηση ανακαλύπτει ότι η ανάπτυξη δεν περιορίζεται από έλλειψη προϊόντων ή demand, αλλά από το ότι το catalog της δεν είναι αρκετά ώριμο ώστε να διανεμηθεί σωστά. Τότε το Product Data Gap μετατρέπεται σε growth constraint.
Ένας καλός κατάλογος μειώνει το cost of expansion
Το αντίστροφο ισχύει επίσης. Όταν το catalog διαθέτει συνεπή identifiers, structured attributes, καθαρές images και σωστά variant relationships, η επέκταση σε νέο channel γίνεται πολύ ευκολότερη.
Το marketing δεν χρειάζεται να ξαναχτίζει product data, τα operations δεν χρειάζεται να κάνουν συνεχές manual reconciliation και το ecommerce team μπορεί να ενεργοποιεί νέα integrations με λιγότερα exceptions.
Η επένδυση στο product-data quality επομένως δεν δημιουργεί μόνο καλύτερο discovery. Δημιουργεί optionality: κάνει την επιχείρηση περισσότερο έτοιμη για το επόμενο channel πριν ακόμη γνωρίζει ποιο ακριβώς θα είναι.
Το visual discovery είναι stress test για το catalog
Αυτό ίσως είναι το πιο χρήσιμο συμπέρασμα. Το visual search δεν δημιουργεί απαραίτητα το Product Data Gap. Συχνά απλώς το αποκαλύπτει.
Αν το catalog είναι καθαρό, το νέο discovery layer μπορεί να αξιοποιήσει εικόνες, identifiers, variants και product attributes πολύ πιο αποτελεσματικά. Αν όμως ο κατάλογος είναι ασυνεπής, το visual discovery κάνει πιο εμφανείς τις αδυναμίες που υπήρχαν ήδη.
Το ίδιο ισχύει και για κάθε νέο ecommerce channel. Τα νέα interfaces δεν αντικαθιστούν το product data. Εξαρτώνται από αυτό.
Από product catalog σε product infrastructure
Ο κατάλογος μιας επιχείρησης δεν είναι πλέον απλώς μια λίστα προϊόντων. Είναι ένα σύστημα που πρέπει να εξηγεί με ακρίβεια τι είναι κάθε προϊόν, ποιο είναι το brand του, ποιο identifier το ξεχωρίζει, ποια variants διαθέτει, πώς φαίνεται, πόσο κοστίζει, αν είναι διαθέσιμο και πώς συνδέεται με τα υπόλοιπα προϊόντα της ίδιας οικογένειας.
Αυτό σημαίνει ότι το catalog έχει εξελιχθεί από back-office database σε customer-facing infrastructure. Και όσο το discovery γίνεται περισσότερο visual, multimodal και automated, τόσο σημαντικότερη γίνεται αυτή η υποδομή.
Το πραγματικό ερώτημα επομένως δεν είναι αν μια επιχείρηση έχει πολλά προϊόντα. Είναι αν τα systems της μπορούν να καταλάβουν σωστά τι ακριβώς είναι αυτά τα προϊόντα.
Αυτό είναι το σημείο όπου κλείνει — ή ανοίγει — το Product Data Gap.
Συχνές Ερωτήσεις (FAQ)
Τι είναι το Product Data Gap;
Το Product Data Gap είναι η απόσταση ανάμεσα στα πραγματικά προϊόντα που διαθέτει μια επιχείρηση και στην ποιότητα, πληρότητα και συνέπεια των δεδομένων που χρησιμοποιεί για να τα περιγράψει ψηφιακά.
Γιατί τα product data είναι σημαντικά για visual discovery;
Γιατί οι εικόνες χρειάζονται σωστό context. Product identifiers, brand, variants, price και availability βοηθούν τα systems να συνδέσουν το visual signal με το σωστό προϊόν.
Ποια product data είναι πιο σημαντικά;
Βασικά στοιχεία περιλαμβάνουν title, image, brand, GTIN ή MPN όπου απαιτούνται, price, availability και σωστά variant attributes. Η Google χρησιμοποιεί αυτά τα δεδομένα για product matching και merchant listing experiences.
Γιατί τα variants δημιουργούν προβλήματα;
Επειδή διαφορετικά χρώματα, μεγέθη, materials ή patterns πρέπει να συνδέονται σωστά με το parent product χωρίς να χάνονται οι διαφορές ανά SKU. Η Google υποστηρίζει ProductGroup markup ακριβώς για αυτή τη σχέση.
Τι είναι ένα PIM;
Ένα Product Information Management system λειτουργεί ως κεντρική υποδομή για την οργάνωση και διανομή product information προς ecommerce platforms, marketplaces και άλλα channels.
Μπορούν λανθασμένα product data να μειώσουν visibility;
Ναι. Η Google αναφέρει ότι incorrect ή missing product information μπορεί να οδηγήσει σε disapprovals, limited eligibility ή incorrect product displays.
Είναι αρκετές οι καλές product images;
Όχι. Οι εικόνες είναι σημαντικές, αλλά πρέπει να συνδέονται με σωστά identifiers, attributes, variants, structured data και availability information.